Créer un dashboard Splunk d’audience avec les logs Nginx

La licorne Geekeries transforme d’anciens tableaux de bord en un dashboard Splunk d’audience qui sépare visiteurs humains et robots

Bonjour à tous, une fois les logs Nginx de Geekeries.org correctement ingérés dans Splunk après la dernière upgrade serveur, j’avais une question assez simple : est-ce que je pouvais faire un « vrai » dashboard Splunk de mesure d’audience, façon Google Analytics, mais sans ajouter de JavaScript, de cookie ou de nouveau tracker dans votre navigateur ?

Je voulais connaître les pages lues, les sources du trafic, les appareils utilisés et la place occupée par les robots. Je voulais aussi les visiteurs uniques, le nombre de sessions ou encore le taux de rebond. Tout en sachant que Nginx n’observe qu’une suite de requêtes HTTP. Il ne voit ni vos clics dans la page, ni votre scroll, ni le moment où vous partez faire un café en laissant l’onglet ouvert.

Le projet a commencé avec douze vieux (genre j’y avais pas touché depuis 4 ans) dashboards récupérés de mon précédent serveur. Il s’est terminé avec une vue Audience & Web Analytics de 26 panneaux, directement alimentée par les journaux du site. Entre les deux, le plus gros travail n’a pas été de dessiner des camemberts (Ca Splunk le fait très bien). Il a fallu décider ce que les données permettaient … Lire la suite
The percentage of small buckets… – Splunk

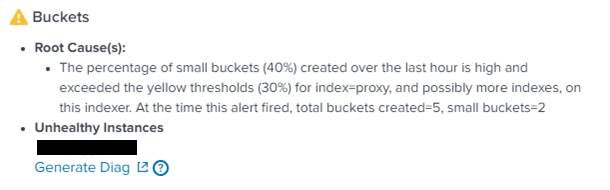
Bonjour à tous, aujourd’hui je vous partage un bug que j’ai rencontré avec un instance Splunk il y a quelques temps de ça. L’erreur en question était celle-ci : « The percentage of small buckets (40%) created over the last hour is high and exceeded the yellow thresholds (30%) for index« . J’ai mis un moment à la détricoter.

The percentage of small buckets (40%) created over the last hour is high and exceeded the yellow thresholds (30%) for index

Après quelques recherches (ici, là), j’ai fini par identifier la root-cause : des logs sui arriveraient avec « trop de retard » par rapport à leur date réelle d’émission. Ce délai forcait Splunk, qui range les données dans les Bucket de manière temporellement ordonnée, à recréer des bucket pour ces évènements car ceux correspondant à cette plage temporelle avaient été fermés.

A la recherche des logs pétés

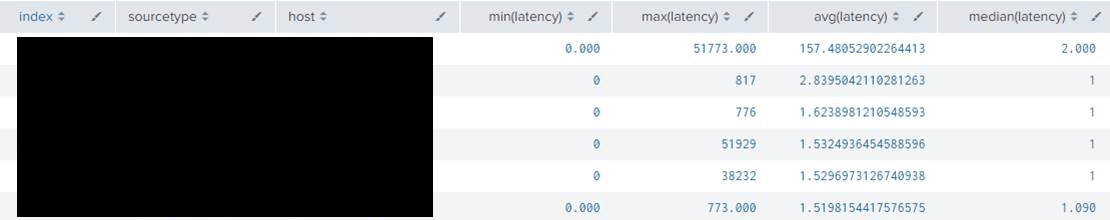
A partir de mon erreur, je me lance donc dans le SPL ci-dessous et effectivement j’ai bien une des sources de logs qui arrivent avec des latences pas normales.

index=<monindex>
| eval latency=_indextime-_time
| stats min(latency),
max(latency),
avg(latency),
median(latency)
by index sourcetype host
| sort - "avg(latency)"
The percentage of small buckets (40%) created over the last hour is high and exceeded the yellow thresholds (30%) for index

Du coup j’ai gratté un peu sur l’hôte en question et il s’avère qu’on a régulièrement des grosses latence à l’indexation, à … Lire la suite

Rsyslog too many open files

Bonjour à tous, aujourd’hui je voulais vous partager une erreur que j’ai rencontrée récemment avec une infra Splunk, plus exactement avec la couche de collecte Rsyslog (vous savez celle que je recommande dans mon podcast sur les 10 commandements du SIEM). Cette erreur qu’on a fini par identifier dans les journaux avec le message suivant « rsyslog too many open files » et plus précisément la ligne suivante :

May 06 05:47:13 myserver rsyslogd[6896]: file '/splunk-inputs/PROXY/myproxyhost/2022-05-06T03+02-PROD-PROXY.log': open error: Too many open files [v8.24.0-41.el7_7.2 try http://www.rsyslog.com/e/2433 ]

Le log d’erreur arrive dans /var/log/message à priori. Néanmoins, de mon côté on ne l’a vu que depuis la commande journalctl, quelques exemples qui m’ont permis de la mettre en avant :

journalctl --no-pager | tail -f
journalctl -u rsyslog
journalctl --no-pager > /tmp/rsyslogtmp.log

Par défaut, la limite pour rsyslog était à 1024 fichiers ouverts simultanément sur notre système. Pas bien clair sur le pourquoi car les limites systèmes (cf. fichier /etc/security/limits.conf) été bien à 64000 :

ulimit -Sn
64000

Pour autant notre processus rsyslog plafonné à 1024 fichiers. Ce qui causait une erreur bien zarb où on perdait 15min de log au début de chaque heure. Du coup, avec l’aide … Lire la suite

BlockList iptable avec Splunk et d’AbuseIPDB

BlockList iptable avec Splunk et d'AbuseIPDB

Bonjour à tous, aujourd’hui je continue avec un article qui suit ce qu’on avait fait avec la Blacklist Iptables AbuseIPDB la dernière fois. Cette fois on va voir comment construire une BlockList iptable avec Splunk et d’AbuseIPDB.

Qu’est ce que j’entends derrière ce titre ? Simplement que la blacklist ma dernière fois n’est pas très « maline ». Dans le sens, où on verrouille juste 10 000 IP comme des bourrins et sans trop se demander si les vulns ou services qu’elles checkent nous concerne en effet. Alors, ça ne sert pas à rien hein. C’est une bonne base à bloquer facilement mais ce n’est pas forcément utile dans le sens où ces 10 000 ne se connecterons pas forcément à votre site ou infra au final.

En effet, ce qu’on souhaiterai plus, notamment dans une optique de CTI (Cyber threat Intelligence) : c’est de bloquer (sinon détecter au moins) celles qui se connectent effectivement sur nos services (genre à la fail2ban). Le problème c’est que fail2ban c’est bien en protection mono instance. Mais, quand vous protégez tout un système d’information, ça ne passe pas super bien à échelle. Par exemple, je vous laisse imaginez quand vous … Lire la suite