Capillotracter et autres xyloglottes

Salut à tous, je ne sais pas vous, mais moi au boulot j’apprécie beaucoup de placer xyloglottes plus souvent appelés : termes idiots type capillotracté ou diptérosodomie ; qui permettent parfois d’égayer un petit peu des réunions avec parfois trop d’antirotondogyrateurs et simplement de dire « poliment » quelques horreurs, sans parler des challenges du type « bingo » entre collègues pour réussir à en placer une contrepèterie ; et autres bêtises sans que ça vois (« c’est ce qu’elle à dit« ).

Et de la même manière qu’il y a quelques temps je vous avais sorti la référence de toutes les manières de dire « toute ressemblance avec… » dans une introduction de présetation, et bien j’ai fini par tomber sur cette page qui en référence plus que je ne pourrais jamais retenir :

https://www.cledut.net/xylo.htm

Quelques exemples choisis :

  • xylocéphalie : gueule de bois ;
  • transrhinoscopie : capacité de voir plus loin que son nez ;
  • schizocardiaque : qui fend le cœur ;
  • scatopode : fouteur de merde ;
  • circonférence : (n.f) Long exposé ou discours sans queue ni tête ;
  • odocéphale : tête de nœud ;
  • orchidoclaste : casse-couille ;
  • entomoquester : chercher la petite bête
… Lire la suite

Calories et montres de sport : des données fiables ?

Calories et montres de sport

Bonjour à tous, ça faisait longtemps que je ne vous avait pas partagé une vidéo. Et cette semaine je suis tombé sur la dernière de Scilabus qui s’est attardée sur les montres de sport et plus particulièrement le sujet des calories et montres de sport.

Comme la dernière de cette chaine que je vous avais partagé, le contenu est là, les données de base sont solides et on apprends 2-3 trucs en plus. Bref, c’est toujours aussi bien les vidéos de Scylabus.

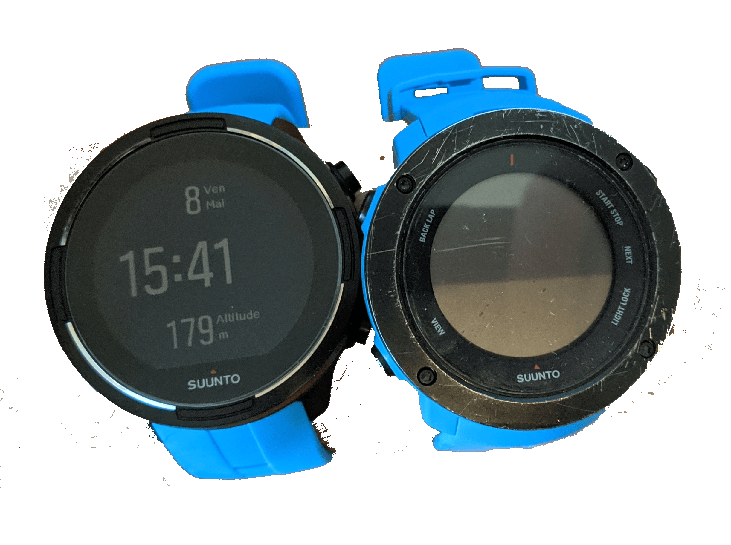
Le seul truc qui m’a vexé c’est que les seules montres qui ne sont pas testées sont celles de la marques que j’ai : Suunto… Un peu vexant, j’aurai bien aimé savoir ce que valait ma nouvelle Suunto 9. Bon au demeurant j’en suis content, c’est le principale… j’ai plus qu’a attendre la fin de la quarantaine pour pouvoir l’utiliser de nouveau !

Pour ceux qui aime gratter les sujets à fond, je vous rappels que les données utiliser pour la vidéo provienne de ce papier de recherche :

How well do activity monitors estimate energy expenditure? A systematic review and meta-analysis of the validity of current technologies

Ruairi O’Driscoll, Jake Turicchi, Kristine Beaulieu, Sarah Scott, Jamie
… Lire la suite

Nouveau format numérique pour MISC Mag : le Flipbook

Salut à tous, une brève cette semaine sur un nouveau format numérique pour MISC Mag proposé par les éditions diamond : le Flipbook. Ça va vous sembler bizarre pour un type qui a déjà publié 3 fois dans le magazine en question, mais en fait j’étais plus abonné chez eux depuis 2013… Pour 2 raisons :

  • Pa vraiment besoin : je me débrouillais toujours pour lire les articles qui m’intéresse via le boulot, via l’abonnement du service ou via le service « CONNECT » quand on l’a eu (oui, je sais, c’est cheap de ma part).
  • Aspect pratique : j’ai déménagé suffisamment souvent ces 15 dernières années (genre 8 fois, depuis 2005) pour savoir que le papier c’est mal et que 10 ans de magazines pèsent quelques chose entre un âne mort et mon humour…

Et puis là, paf, à mon nouveau boulot : on est un peu plus nombreux, on est en flex-space ; et en 6 mois les MISC ils sont toujours pas arrivés jusqu’à moi malgré qu’on soit abonné. En regardant sur leur site, il s’avère que depuis septembre 2019 ils proposent une offre numérique « intermédiaire » entre l’abonnement papier et l’accès à Connect (à 300€/an) … Lire la suite

Extraire le dernier élément de chaque ligne en regex

Extraire le dernier élément de chaque ligne

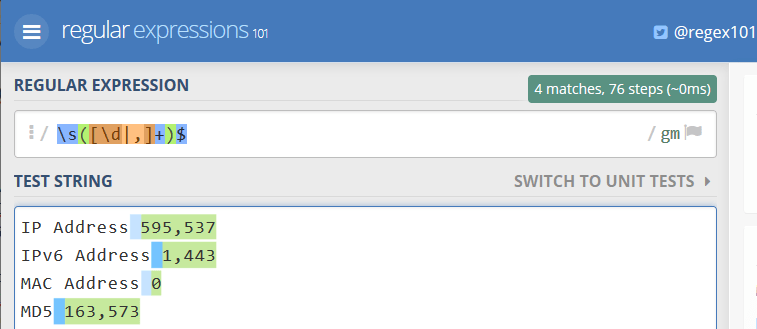
Bonjour à tous, aujourd’hui un petit TP sur les expressions régulières. J’ai un collègue qui m’a demandé comment on pouvait Extraire le dernier élément de chaque ligne dans un bout de texte de quelques centaines de lignes. Voici un exemple de format :

IP Address 595,537
IPv6 Address 1,443
MAC Address 0
MD5 163,573

La première version de la regex que j’ai proposée est simple au possible :

([^\s]+)$

Qui signifie en gros : « tout, sauf les espaces avant la fin de chaque ligne ». Cette expression a quand même un problème avec ses performances (326 steps sur regex101) dans la mesure le moteur d’évaluation avance dans le texte, il ne part pas de la fin et va donc avancer dans chaque mot avant de « backtracker », si celui ci n’est pas suivi de la fin de ligne.

Du coup, j’ai pu proposer une première version optimisée :

^.*?\s([^\s]+)$

C’est l’une des rares cas que j’ai croisé où l’usage d’un .* rends l’expression plus performante (120 steps sur le même texte) en l’obligeant à aller à la fin de ligne directement avant de matcher le dernier bloc. D’après regex101, on est donc déjà 3 fois plus … Lire la suite