Optimiser WordPress : Pnwy sous Stéroide !

La licorne Geekeries allège une page WordPress en retirant une police et des fichiers inutiles

Salut à tous, j’ai profité d’une maintenance récente pour enfin (ré)optimiser le WordPress de Geekeries.org. Pas en installant un énième plugin miracle, mais en regardant ce que le navigateur chargeait vraiment.

Le site n’était pas à genoux. Il fonctionnait, les pages s’ouvraient, et personne ne m’avait signalé de catastrophe. PageSpeed lui me scorait pourtant à 72 sur mobile et 73 sur ordinateur. Le plus visible était le décalage de mise en page : le logo arrivait sans dimensions réservées et poussait le contenu pendant le chargement.

J’ai donc repris la chaîne complète, du reverse proxy jusqu’au navigateur, avec deux règles assez simples : une modification à la fois, et un retour arrière prêt avant de toucher à la production. Pwny m’a aidé à faire l’inventaire et à préparer les contrôles, et les appliquer mais chacun autorisé et vérifié manuellement.

Le serveur n’était pas le principal coupable

Une requête sur le site suit ce chemin : visiteur → Nginx Proxy Manager → Nginx et PHP → WordPress → MariaDB et Redis. Mon premier réflexe aurait pu être de régler PHP-FPM ou d’ajouter encore du cache. Les mesures racontaient autre chose.

Une fois la page anonyme servie à chaud, le TTFB… Lire la suite
Build a CSIRT Second Brain with OpenCode, Obsidian, MCP, and an AbuseIPDB custom tool

CSIRT second brain: workshop introduction (French)

Bonjour à tous ! Le 1er octobre 2026, j’ai animé à Stockholm un atelier consacré au « CSIRT second brain » (ou « second cerveau » en français), pour les équipes de réponse à incident. Il s’inscrivait dans le cadre des 78e rencontres du TF-CSIRT, organisées en Suède du 29 septembre au 1er octobre (auxquelles j’ai aussi assisté 😊).

J’ai préparé cet atelier suite au meeting précédent du TF-CSIRT à Riga au printemps, où plusieurs personnes m’ont demandé de montrer comment on s’y prend au CERT pour qualifier nos incidents avec des agents. Et autant c’est « assez simple » à expliquer, autant l’implémentation réelle en prod est vite complexe à reproduire : entre le choix des LLM, les tools, les MCP, les skills et les bases de connaissances…

Mettre tout ça en musique dans un atelier suffisamment simple pour que tout le monde comprenne en une demi-journée, gratuitement, mais suffisamment complexe pour être représentatif de la réalité, c’était un beau challenge sur lequel je me suis fait des nœuds au cerveau… pour vous sortir la version la plus simple d’un agent SOC/CSIRT de qualification d’incidents.

L’idée de mon workshop est de conserver … Lire la suite

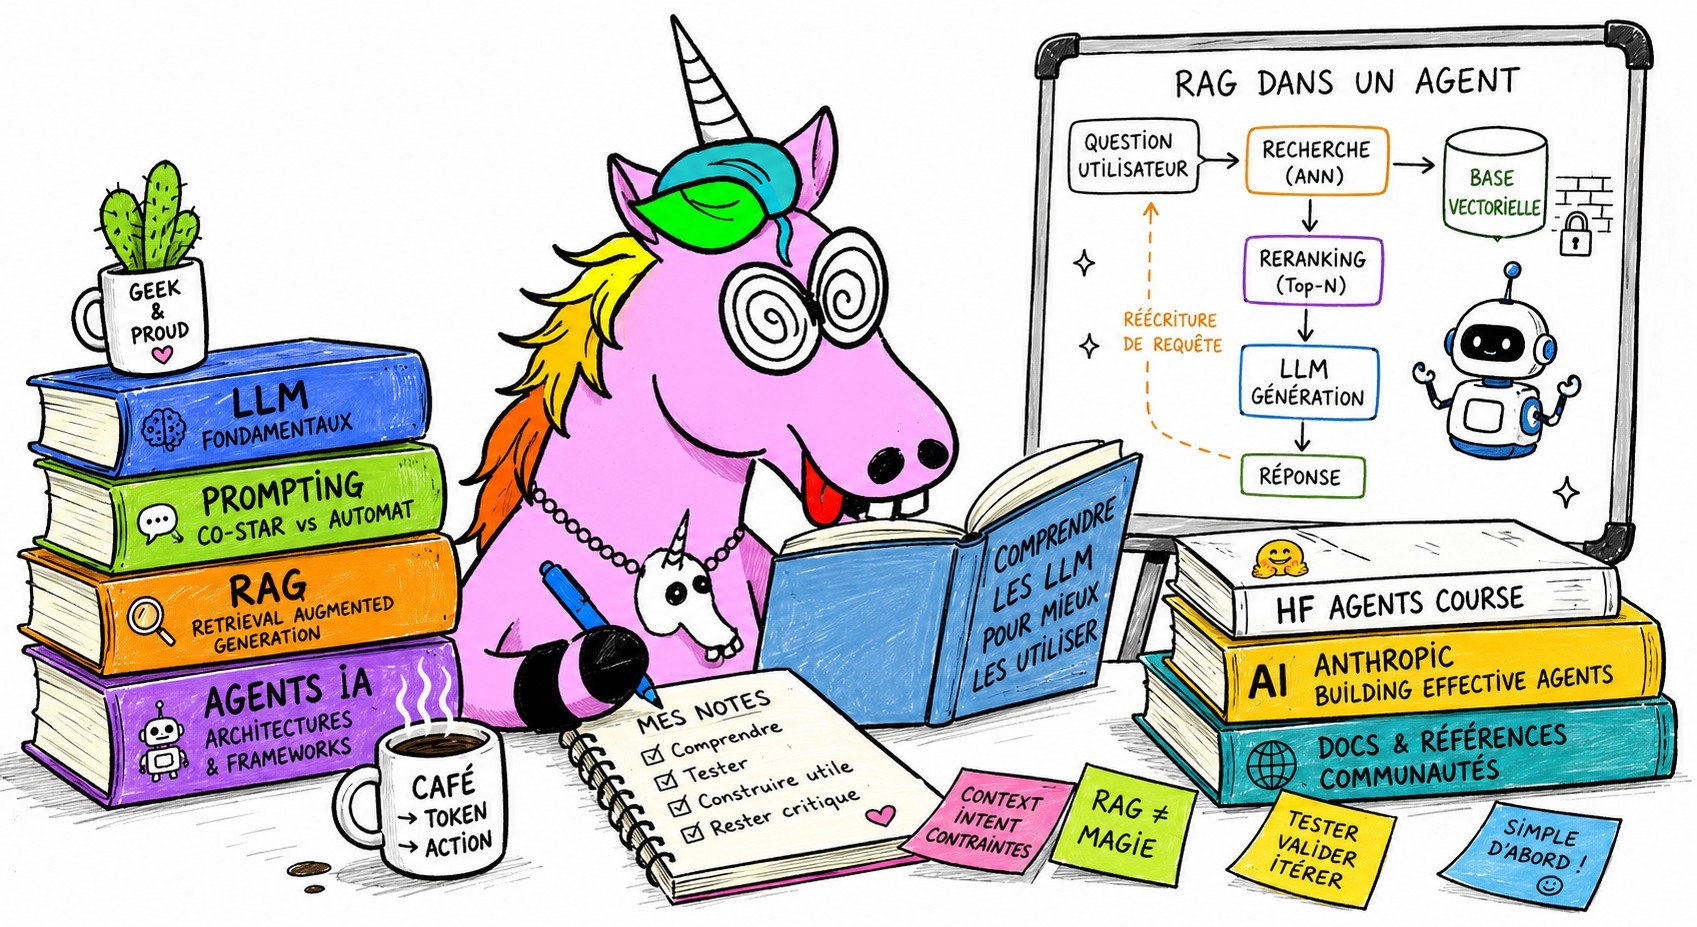
LLM, prompting, RAG et agents IA : mes ressources pour y voir plus clair

Ressources pour comprendre les LLM, le prompting, le RAG et les agents IA Emplacement image : Image mise en avant WordPress

Hello à tous, je me suis récemment consolidé une petite liste de ressources pour remettre un peu d’ordre dans tout ce qu’on lit sur les LLM et agents IA. Entre les modèles, les frameworks et les acronymes qui poussent plus vite que mes containers Docker, il devient facile de perdre le fil.

Comprendre ce qu’il y a dans la boîte noire

Pour commencer doucement, le cours de Louis-François Bouchard sur les LLM sans maths est une bonne porte d’entrée.

Mais si vous voulez vraiment comprendre ce qui se passe dans la boîte noire, je vous conseille aussi le document de JT Graveaud, « Plonger au cœur des LLM sans faire de maths ». Il déroule progressivement tokenization, embeddings, transformeurs, attention multi-têtes puis génération auto-régressive. J’aime particulièrement l’approche : suffisamment technique pour comprendre pourquoi le modèle fait ce qu’il fait, mais sans vous demander de refaire les calculs matriciels sur un coin de table. Et il ne cache pas les limites : hallucinations, biais, consommation de ressources ou fenêtre contextuelle.

Si vous voulez ensuite mettre les mains dedans, l’incontournable LLM Course de Hugging Face est l’étape logique. C’est gratuit, beaucoup plus technique, et Python devient clairement votre ami.

Avant

… Lire la suite

CrowdSec et Nginx Proxy Manager : protéger Docker sans image custom

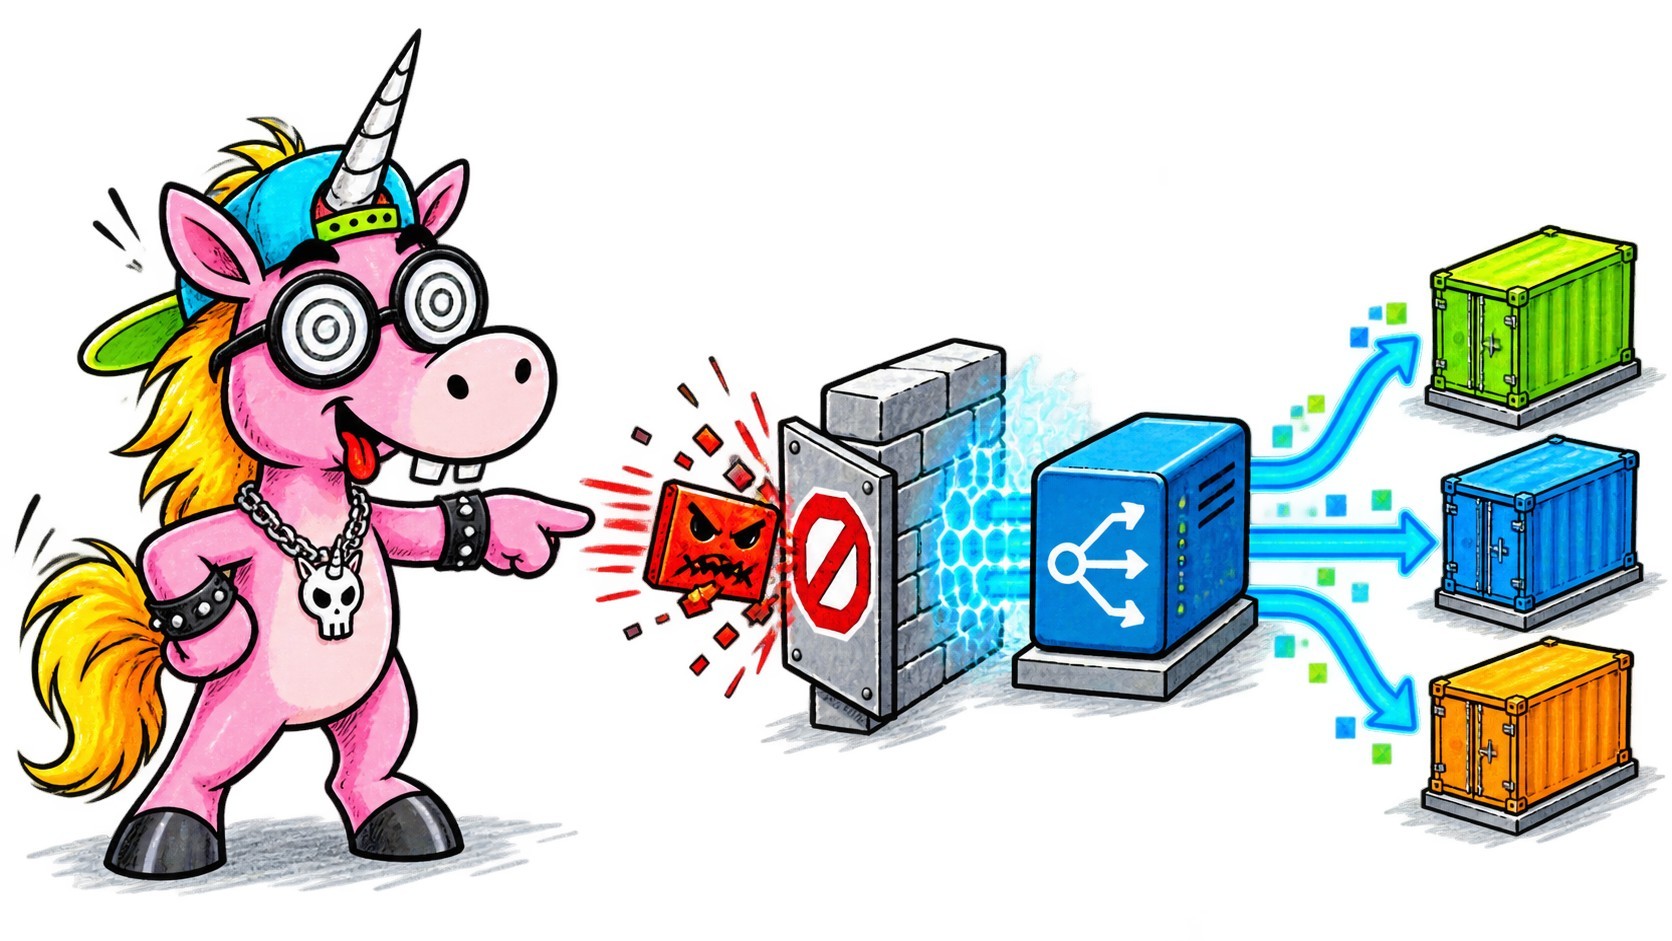
Une licorne Geekeries bloque un paquet web suspect avec CrowdSec Nginx Proxy Manager devant des conteneurs Docker

Salut les Geeks ! Après avoir protégé les Basic Auth avec Fail2ban devant Nginx Proxy Manager, je voulais compléter la défense contre les scans et comportements HTTP plus larges. Le résultat est un filtrage CrowdSec pour mon Nginx Proxy Manager qui conserve l’image officielle du proxy, observe d’abord, puis bloque les décisions au firewall, y compris pour les flux Docker.

Comme vous allez le voir, ce n’est pas un WAF HTTP. CrowdSec apprend à partir de l’activité déjà vue par le proxy qui lui est transféré, puis le firewall refuse les adresses IP décidées comme malveillantes depuis les liste souscrites chez CrowdSec. C’est moins riche qu’une inspection HTTP intégrée, mais c’est une solution simple, maintenable et adaptée à une installation NPM Docker existante.

Pourquoi je n’ai pas fabriqué une image NPM avec un bouncer Nginx

La première piste semblait évidente : intégrer le bouncer CrowdSec directement dans Nginx Proxy Manager. En pratique, cela suppose l’installation de Lua ou d’OpenResty, des modules spécifiques : donc une image dérivée de NPM, un fork ou une image communautaire. Certaines recettes existantes reposent sur des images peu suivies. Pour un reverse proxy exposé sur Internet, je ne voulais ni dépendre d’une image custom, … Lire la suite